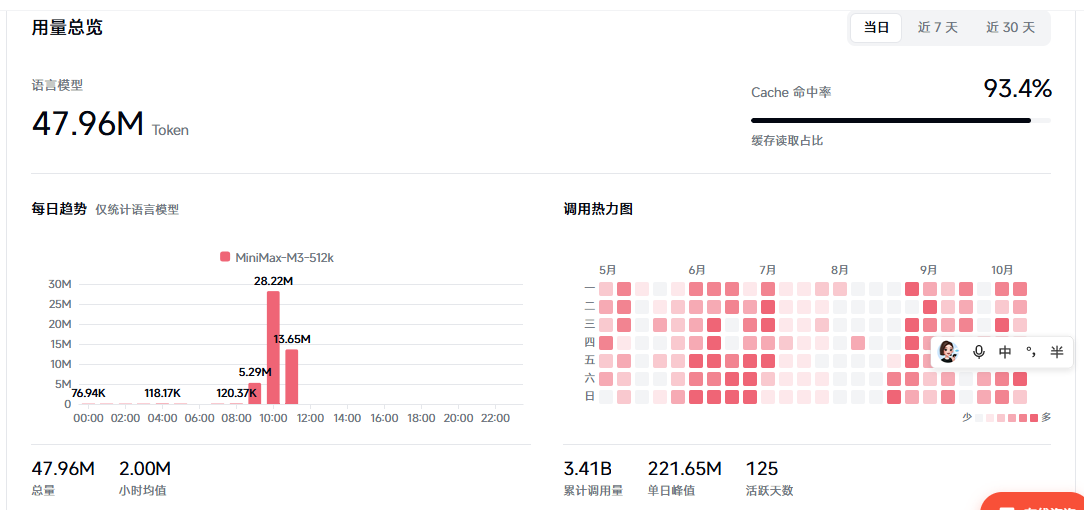
这是 MiniMax API 的套餐用量面板,统计语言模型(M3-512k)的调用数据:
核心指标
- 总 Token:47.96M(4796 万 token)
- Cache 命中率:93.4% ✅ 非常优秀
Cache 缓存:把重复的上下文缓存,不计费 / 大幅降价,93.4% 意味着绝大多数输入 token 没有扣费;你实际付费的 token 远低于 47.96M。这是 API 调用优化做得很好的标志。
- 累计调用量:3.41B(34.1 亿次 API 请求)
- 单日峰值:221.65M token
- 活跃天数:125 天
- 小时均值:2.00M token
每日趋势图(当日分时)
- 模型:MiniMax-M3-512k
- 流量集中爆发时段:早上 8 点~中午 12 点
- 10 点:28.22M(当日峰值)
- 11 点:13.65M
- 9 点:5.29M
- 其余时段流量很低,是典型的白天集中使用、夜间低负载。
调用热力图
横轴:5 月~10 月;纵轴:周一到周日 颜色越深 = 调用量越大:
- 5-7 月持续稳定调用
- 8 月用量明显降低(大面积浅色)
- 9、10 月调用量重新回升,恢复到之前水平
结合你前面做轻量 OpenWebUI 项目的分析
1. 这个数据代表什么场景?
4796 万 token、125 天活跃,大概率是个人 / 小服务接入 MiniMax API,不是超大商业项目。 93.4% 缓存命中率说明:大量对话是复用相同系统提示词 + 历史上下文,刚好就是聊天 WebUI 的典型流量特征(每次对话带上历史消息)。
这也印证:做轻量 WebUI 时,一定要支持上下文缓存,能极大降低 API 成本,这可以作为你项目的亮点功能。
2. 对你开源 WebUI 项目的启发
- 内置缓存策略 MiniMax、OpenAI 兼容接口都支持 prompt cache。你的轻量 WebUI 可以增加自动上下文缓存,减少用户 token 开销,会成为和 OpenWebUI 的差异化卖点。
- 多 API 厂商切换 你现在在用 MiniMax,做项目时支持同时对接 Ollama 本地模型 + MiniMax + 其他 OpenAI 兼容 API,用户可以自由切换本地 / 云端模型。
- 用量统计面板 你截图里这种简洁用量看板,OpenWebUI 的用量统计比较笨重。你的简化版 WebUI 可以内置轻量 token 统计、缓存命中率展示,满足个人用户看消耗的需求,不用跳转到厂商控制台。
- 流量特征参考 你的用户(NAS / 自托管玩家)很多会混合:白天跑云端 API(MiniMax/DeepSeek),夜间切本地 Ollama。你的 UI 可以加简单的时段模型自动切换。
3. 成本估算参考(MiniMax M3)
因为缓存 93.4%,实际计费 token ≈ 总 token × (1-0.934) 47.96M × 6.6% ≈ 3.16M 计费 token。 也就是说,名义 4796 万 token 流量,实际只需要为约 316 万 token 付费。这就是缓存的巨大价值。
评论 (0)
暂无评论。
发表留言